מי שמקליד בגוגל "OCR בעברית" או "זיהוי טקסט בעברית מתמונה" בדרך כלל כבר נכווה: סרק מסמך, הריץ עליו זיהוי טקסט, ובאנגלית יצא מושלם ובעברית יצא סלט. זה לא דמיון וזו לא רשלנות של מי שסרק. עברית באמת קשה יותר למחשב, מכמה סיבות שאפשר להסביר בלי מילה אחת של מתמטיקה. ומי שצריך שהעמוד יוקרא לו בקול, כי הוא רואה פחות או כי קריאה מאמצת אותו, שומע כל אחת מהן באוזן.
מה זה בכלל OCR, בפסקה אחת
OCR (Optical Character Recognition, זיהוי תווים אופטי) הוא התהליך שבו תוכנה מסתכלת על תמונה, סריקה, צילום מסך או PDF שאי אפשר לסמן בו טקסט, ומנחשת אילו אותיות מצוירות שם. המילה "מנחשת" מדויקת: אין שם טקסט מוסתר שהתוכנה שולפת. יש רק פיקסלים, והתוכנה משווה את הצורות שהיא רואה למה שלמדה מדוגמאות. מנוע הקוד הפתוח הנפוץ ביותר נקרא Tesseract: הוא פותח במקור בחברת HP, שוחרר כקוד פתוח, ומאז גרסה 4 הוא מבוסס על רשת עצבית ומכיר יותר ממאה שפות. עברית ביניהן. אבל "מכיר" ו"קורא היטב" הם שני דברים שונים.
חמש סיבות שבגללן עברית קשה יותר
1. אותיות סופיות
לחמש אותיות בעברית יש צורה אחרת בסוף מילה: ך ם ן ף ץ. לעין שלכם זה טבעי. למנוע זיהוי זו החלטה נוספת בכל מילה: האם זו כ"ף רגילה, או כ"ף סופית שהרגל שלה נחתכה בסריקה? האם זו מ"ם סופית או סמ"ך? בטקסט קטן או מעט מטושטש, ההבדל בין ן ל-ו ל-ז הוא כמה פיקסלים. באנגלית אין בעיה מקבילה: לאף אות אין צורה שונה בסוף מילה.
2. ניקוד ונקודות שנראות כמו לכלוך
ניקוד הוא סימנים קטנים מתחת לאותיות, מעליהן או בתוכן, שמסמנים תנועות. בספרי ילדים, בסידורים, בשירה ובחומרי לימוד לעולים יש ניקוד מלא. עבור מנוע זיהוי, נקודה קטנה מתחת לאות נראית בדיוק כמו פסיק, כמו גרגר אבק בסריקה או כמו חלק מהאות שמעליה. התוצאה: אותיות שמתמזגות עם הניקוד, פסיקים שצצים באמצע מילים, ומילה מנוקדת שיוצאת שונה ממילה זהה בלי ניקוד. גם דגש בתוך האות, הנקודה שמבדילה בין בּ ל-ב, הוא בדיוק סוג הפרט שנעלם בסריקה בינונית.
3. מימין לשמאל, עם אנגלית באמצע
עברית נכתבת מימין לשמאל, אבל כמעט כל עמוד עברי מודרני מכיל גם משהו משמאל לימין: שם של תוכנה, כתובת אתר, מונח באנגלית, מספרים. תקן יוניקוד מבחין בין "סדר לוגי" (הסדר שבו קוראים את המילים) ל"סדר ויזואלי" (הסדר שבו הן מצוירות על השורה), ותוכנות התצוגה עושות את ההמרה בשקט. מנוע OCR מקבל רק את הציור. הוא רואה מילים על שורה, ולפעמים מחזיר אותן בסדר שבו הן מופיעות משמאל לימין, ולא בסדר שבו אדם קורא אותן.
מה זה אומר למי שמקשיב? בבדיקות שלנו, כותרת שכתוב בה "הגדרות מתקדמות" ולידה התרגום Advanced Settings חזרה מהמנוע כשהאנגלית קודם: שומעים "Advanced Settings" ורק אחר כך "הגדרות מתקדמות". שורה ברשימת קניות שכתוב בה "חלב" עם Milk לצדה הוקראה כ-"Milk" ורק אז "חלב". המילים כולן נכונות; הסדר הפוך. באנגלית בלבד הבעיה הזו לא קיימת בכלל.
4. אותיות עבריות שדומות לאותיות לטיניות
כשמנוע אחד צריך להכיר גם עברית וגם אנגלית, כל צורה מטושטשת הופכת לשאלה: זו ו או l? זו ם או o? זו ח או n? מספיק שהמנוע יחליט לא נכון על האות הראשונה, והוא ננעל על השפה הלא נכונה לשארית המילה. בבדיקות שלנו זה קרה לשני הכיוונים:
- המילה
Safari,חזרה כרצף של אותיות עבריות וספרות, משהו כמו "וח8ז58,". - הקיצור
Ctrl+Cחזר כמילה שנראית עברית: "העצתקה". - המילה
English.חזרה כ-"חפווסחם.". - ובכיוון ההפוך: המילה "איזה" חזרה כ-
ATR, והמילה "אפשר" חזרה כ-WOR.
שימו לב מה קורה כשמקריאים את זה בקול. "וח8ז58" זו לא טעות קטנה שאפשר לדלג עליה, זה רעש באוזן, באמצע משפט. זה ההבדל בין OCR שנועד לחיפוש בארכיון, שם מילה שגויה אחת לא נורא, לבין OCR שנועד להקראה.
5. טקסט קטן על המסך
באנגלית יש מעט אותיות שדומות זו לזו (l ו-I, O ו-0). בעברית יש זוגות ושלשות שלמים שההבדל ביניהם הוא קו קצר או זווית: ב/כ, ד/ר, ה/ח, ו/ן/ז. כשהטקסט על המסך קטן, כמו בתפריטים, בהערות שוליים או ב-PDF שמוצג בעמוד שלם, האותיות האלה נמרחות על כמה פיקסלים בודדים, וההבדל פשוט לא קיים בתמונה. לכן הגדלה של התמונה לפני הזיהוי עוזרת: היא לא מוסיפה מידע חדש, אבל היא נותנת למנוע יותר פיקסלים לכל אות, וזה מה שהוא צריך כדי להבדיל בין ד ל-ר. חשוב לדעת שההפך גם נכון: להגדיל טקסט שכבר גדול לא עוזר, ולפעמים מזיק.
מה אתם יכולים לעשות כדי לעזור למנוע
לא צריך להבין את המנוע כדי לעזור לו. כמה הרגלים פשוטים משנים את התוצאה יותר מכל הגדרה:
- הגדילו לפני שאתם מקריאים. בדפדפן, ב-PDF, במסמך: הגדלת התצוגה (ברוב התוכנות
Cmdועוד+) לפני ההקראה נותנת למנוע אותיות גדולות וברורות. זה השינוי הזול ביותר עם ההשפעה הגדולה ביותר. - סריקה נקייה. אם אתם סורקים דף נייר: ישר, בתאורה אחידה, בלי צל של היד ובלי קיפול באמצע העמוד. רזולוציה רגילה של סורק ביתי מספיקה; הבעיה היא כמעט תמיד צללים ועקמומיות, לא רזולוציה.
- בחרו רק את מה שצריך. כשמקריאים אזור, סמנו את גוף הטקסט בלבד: בלי סרגל צד, בלי תמונות ובלי תפריט. כל דבר שאיננו טקסט הוא הזדמנות למנוע להמציא מילים.
- עמודים מעורבים: פסקה אחר פסקה. אם העמוד מלא במונחים באנגלית בתוך עברית, הקראה של פסקה אחת בכל פעם מקטינה את הסיכוי שהסדר יתבלבל.
מה קלי (KaliReader) עושה עם זה
קלי (KaliReader) הוא קורא מסך למק שנבנה בדיוק בשביל המצב הזה: לצלם את מה שמופיע על המסך, לזהות בו את הטקסט ולהקריא אותו בקול עם הדגשה של כל מילה. הנה מה שקורה מאחורי הקלעים, בלי לייפות.
מודל עברי ואנגלי יחד, לא המנוע של Apple. למערכת זיהוי הטקסט המובנית במק אין מודל עברי. Apple חושפת את רשימת השפות הנתמכות דרך ממשק למפתחים, ועברית לא נמצאת בה, ולכן טקסט עברי שנשלח אליה חוזר כאותיות לטיניות. זו גם אחת הסיבות שקורא מסך מובנה לא מספיק לעמוד שאי אפשר לסמן בו טקסט. קלי משתמש במקום זאת ב-Tesseract, כשהמודל העברי והמודל האנגלי טעונים יחד, ומגיע ארוז עם המנוע ועם קובצי השפה. אין מה להתקין.
הגדלה חכמה של טקסט קטן. לפני הזיהוי התמונה עוברת לגווני אפור עם מעט חיזוק של הניגודיות. אחר כך קלי מודד את גובה האותיות בפועל: אם הן קטנות, הוא מגדיל את התמונה בדיוק בכמה שצריך ומריץ את הזיהוי שוב. אם הן כבר גדולות, הוא משאיר אותן כמו שהן, כי הגדלה מיותרת פוגעת.
כל מילה יודעת איפה היא. כדי להדגיש כל מילה תוך כדי ההקראה, קלי לא מסתפק בטקסט: הוא מקבל מהמנוע גם את המיקום של כל מילה, ומסדר שורות מעורבות לסדר קריאה. זה בדיוק המקום שבו שורות עם הרבה אנגלית עדיין מכשילות אותו לפעמים, כמו בדוגמאות למעלה.
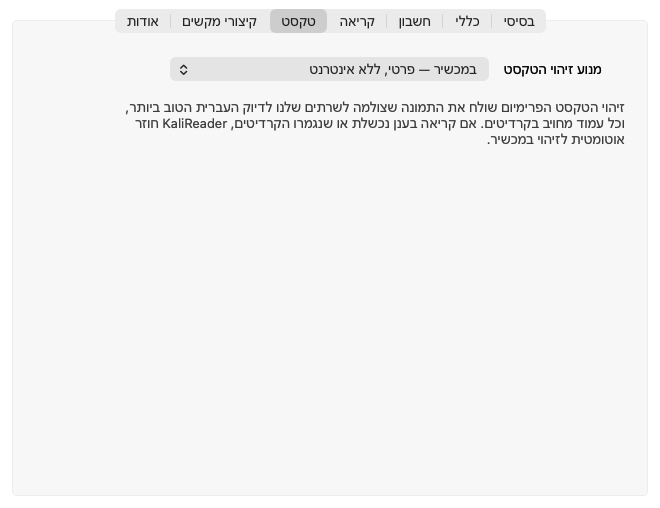
מנוע ענן אופציונלי לעמודים קשים. למנויים יש בהגדרות, בלשונית "טקסט", אפשרות לשלוח את התמונה שצולמה למנוע זיהוי בענן. זה לא קסם, ואנחנו לא מבטיחים שכל עמוד ייצא מושלם: בחלק מהעמודים הקשים זה עוזר, ובאחרים לא. אם הקריאה בענן נכשלת, קלי חוזר אוטומטית לזיהוי במכשיר. הזיהוי במכשיר עצמו עובד בלי אינטרנט, בלי הגבלה, ושום דבר לא יוצא מהמק שלכם. כדאי לזכור את ההבדל: מה שנשלח לענן הוא צילום של המסך, על כל מה שמופיע בו.
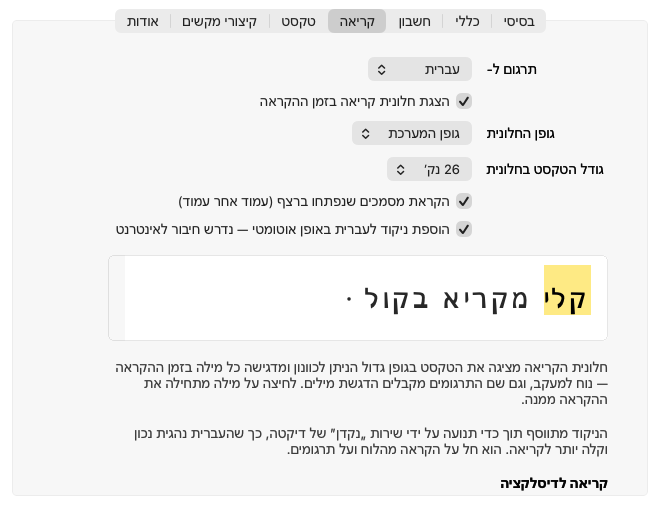
וניקוד? אחרי הזיהוי, לא במקומו. קלי לא מנסה לקרוא ניקוד מהתמונה. במקום זה, בלשונית "קריאה" אפשר להפעיל הוספת ניקוד אוטומטית לטקסט שכבר זוהה, דרך שירות הנקדן של דיקטה (נדרש חיבור לאינטרנט), כדי שהקול יהגה את המילים נכון וכדי שהטקסט בחלונית הקריאה יהיה קל יותר לקריאה.
מה עדיין נכשל, בכנות
- כתב יד. מנועי OCR שאומנו על טקסט מודפס, וזה כולל את המנוע שקלי מריץ במכשיר, לא נועדו לכתב יד. פתק בכתב יד, טופס שמולא בעט או הערה בשולי ספר יחזרו ברובם כרעש.
- גופנים דקורטיביים. לוגואים, כותרות מעוצבות, פונטים שמחקים כתב יד בהזמנות ובפרסומות: ככל שהאות רחוקה מהצורה הסטנדרטית שלה, כך המנוע מנחש יותר.
- שורות מעורבות צפופות. טבלה שבכל תא שלה יש עברית ואנגלית, או שורת קוד בתוך פסקה עברית, עדיין יכולות לחזור בסדר הפוך.
- סריקות גרועות. צל כבד, עמוד עקום או צילום מטושטש מהטלפון מכשילים כל מנוע, בעברית ובאנגלית כאחד. ההבדל הוא שבעברית זה נשמע גרוע יותר, כי יש יותר אותיות שנראות דומות.
אז כן, OCR בעברית קשה יותר מאנגלית, ומי שאומר לכם אחרת לא הריץ אותו על עמוד אמיתי. אבל רוב הקושי הוא צפוי, ורוב מה שצפוי אפשר לטפל בו: להגדיל, לסרוק נקי, לבחור את האזור הנכון, ולתת למנוע מודל עברי אמיתי. אם יש לכם עמוד שאתם רוצים לשמוע במקום לנחש, הורידו את קלי (KaliReader) למק ונסו אותו על המסמך שלכם, או עברו על המסלולים בעמוד המחירים. ואם הבעיה שלכם היא ספציפית ל-PDF סרוק או לצילום מסך, כתבנו על זה בנפרד: איך מקריאים PDF, סריקה או צילום מסך בעברית.
מקורות
- Tesseract OCR, README (GitHub) (נבדק ב־4 בספטמבר 2026)
- tessdata_best, trained LSTM models for Tesseract (GitHub) (נבדק ב־4 בספטמבר 2026)
- Apple Developer Documentation, VNRecognizeTextRequest.supportedRecognitionLanguages() (נבדק ב־4 בספטמבר 2026)
- Unicode Standard Annex 9, Unicode Bidirectional Algorithm (נבדק ב־4 בספטמבר 2026)
- ויקיפדיה, אותיות סופיות (נבדק ב־4 בספטמבר 2026)
- ויקיפדיה, ניקוד (נבדק ב־4 בספטמבר 2026)